
W skrócie (TL;DR)
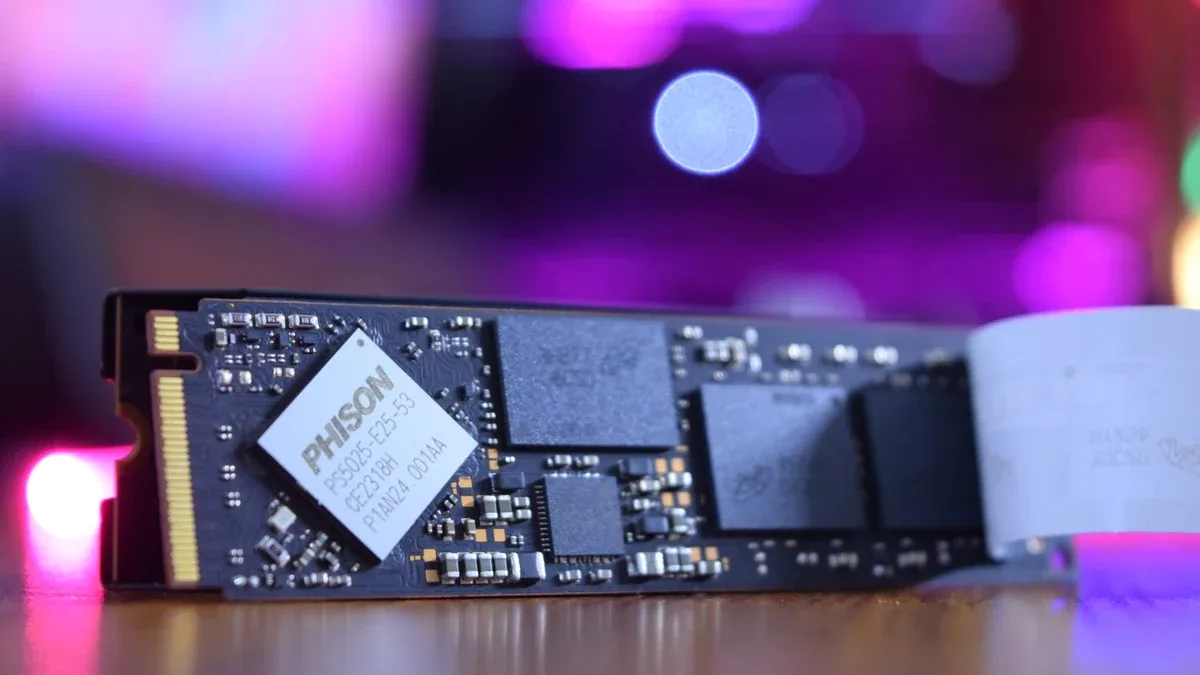
- Phison pokazał prototyp dysku SSD z wbudowanym procesorem NPU i 64GB pamięci o przepustowości 130 GB/s
- Dysk obsługuje PyTorch, vLLM, OpenVINO i llama.cpp — można uruchamiać modele AI bezpośrednio na dysku
- Potencjalnie zmniejsza transfer danych nawet 100-krotnie dla określonych obciążeń, oszczędzając energię i pasmo
- To rozwiązanie dla serwerów enterprise; brak daty dostępności i oficjalnej nazwy produktu
Na konferencji Supercomputing 2026 (SC26) Phison zaprezentował coś, na co inżynierowie data center czekają od lat — dysk SSD, który nie tylko przechowuje dane, ale je również przetwarza. Nie jest to pierwsza próba computational storage na rynku, ale Phison podchodzi do problemu inaczej niż poprzednicy.
Pokazano dwa prototypy. Pierwszy wyposażony jest we wbudowany procesor NPU i 64GB pamięci. Drugi łączy szybką pamięć pSLC z dużą pojemnością QLC pod jednym kontrolerem. Oba rozwiązania pozostają w fazie rozwojowej — Phison wyraźnie zaznacza, że produkty i funkcje są wciąż opracowywane.

Dysk z procesorem: inferencja tam, gdzie są dane
Koncepcja computational storage nie jest nowa. Samsung próbował tego w 2018 roku z SmartSSD, umieszczając FPGA na dysku. Idea była prosta: zamiast wysyłać gigabajty danych do CPU, przetwarzaj je lokalnie i odsyłaj tylko wyniki. Teoretycznie brzmi świetnie. W praktyce? SmartSSD zniknął z rynku.
Phison uczy się na tym błędzie. Jego dysk z NPU obsługuje popularne frameworki AI — PyTorch, vLLM, OpenVINO, llama.cpp. To oznacza, że deweloperzy mogą uruchamiać modele bez pisania specjalistycznego kodu. Elastyczność zamiast specjalizacji. To kluczowa różnica.
Wbudowany procesor ma dostarczać 36 800 DMIPS — to archaiczna miara z lat 80.. Bardziej istotne są parametry pamięci: 64GB o przepustowości 130 GB/s (prawdopodobnie LPDDR5X). Dla porównania, dysk może osiągnąć do 28 GB/s do hosta (jeśli to PCIe 6.0), więc pamięć jest ponad 4x szybsza niż połączenie z serwerem. To ma znaczenie.
Oszczędność transferu: 10 do 100 razy mniej danych
Phison twierdzi, że dla odpowiednich obciążeń dysk może zmniejszyć transfer danych od 10 do 100 razy. To nie są liczby z powietrza — to wynika z samej natury problemu. Jeśli serwer musi przeskanować miliardy rekordów w bazie danych, aby znaleźć kilka istotnych wyników, tradycyjnie wysyła wszystko do CPU. Dysk Phison może to zrobić lokalnie i odesłać tylko wyniki.
Dla hyperscalers to oznacza mniej obciążenia CPU, mniej energii, mniej czasu oczekiwania. Dla firm zajmujących się przetwarzaniem dużych ilości danych — a takich jest coraz więcej w erze AI — to potencjalnie znaczące oszczędności operacyjne.
Phison pokazał to na przykładzie bazy danych: skanowanie dużych zbiorów danych z użyciem tradycyjnego SSD wymaga transferu całych zbiorów do CPU. Dysk z NPU może filtrować dane na miejscu, zmniejszając obciążenie procesora. Teoretycznie może to uwolnić CPU do innych zadań.
Drugi projekt: pamięć pSLC i QLC pod jednym kontrolerem
Drugi prototyp Phison to rozwiązanie bardziej pragmatyczne — dysk łączący szybką pamięć pSLC (1-bitową) z dużą pojemnością QLC (4-bitową) pod jednym kontrolerem. To 16-kanałowa konstrukcja, więc nie należy jej porównywać z dyskami konsumenckimi.
Pomysł jest prosty: dane o wysokiej częstotliwości zapisu trafiają do pSLC (szybko, trwale), dane read-heavy do QLC (wolniej, ale tanio). Każdy region ma własną przestrzeń nazw, więc system operacyjny widzi je jako osobne dyski. Phison twierdzi, że to zmniejsza potrzebę dedykowanych dysków cache.
Tradycyjnie serwery mają osobne dyski cache (SLC) i pojemnościowe (QLC). To zajmuje więcej miejsc w szafie, komplikuje architekturę. Phison proponuje jedno urządzenie. Kompromis? Awaria jednego dysku oznacza stratę zarówno cache, jak i pojemności. Ale z drugiej strony — każdy slot dyskowy przyczynia się do rzeczywistej pojemności, nic się nie marnuje. Phison wylicza też, że przy 24 dyskach awaria jednego oznacza utratę tylko 4% cache, a przy dedykowanych dyskach cache – 25%.
Historia computational storage: dlaczego poprzednie próby upadły?
Samsung SmartSSD z FPGA był ambitny, ale wymagał od klientów pisania kodu dla każdego przypadku użycia. To oznaczało wysokie koszty wdrożenia i brak uniwersalności. Druga generacja z AMD Xilinx Versal FPGA obiecywała ponad 50% krótszy czas przetwarzania i do 70% mniej energii — ale dysk według doniesień zniknął z oferty Samsunga.
ScaleFlux poszedł inną drogą — kompresja na dysku, niewidoczna dla hosta. Dysk wygląda jak zwykły NVMe. Brak zmian w aplikacjach. Ich CEO twierdzi, że to jedyna computational storage w produkcji u hyperscalers. To sugeruje, że klucz do sukcesu to nie wymuszanie zmian na klientach.
Phison wydaje się rozumieć tę lekcję. Obsługa popularnych frameworków AI bez specjalistycznych narzędzi to krok w dobrym kierunku. Ale czy to wystarczy? Historia pokazuje, że computational storage ma trudną drogę do masowej adopcji.
Przyszłość: PCIe 7.0 i 1,8 TB/s
CTO Phisona Sebastien Jean mówił na panelu o kierunkach rozwoju. Dyski PCIe 7.0 mają osiągać 50-56 GB/s. Z 32 takimi dyskami w jednej obudowie można uzyskać 1,8 TB/s przepustowości. To dla HPC — high-performance computing.
To pokazuje, że Phison myśli długoterminowo. Computational storage to nie jeden dysk — to całosystemowe podejście do architektury serwerów. Jeśli to się powiedzie, może zmienić sposób, w jaki data center przetwarzają dane AI.
Co to oznacza w praktyce?
Dla firm zajmujących się przetwarzaniem dużych ilości danych (banki, telekomy, e-commerce z ML) — potencjalnie niższe rachunki za energię i szybsze przetwarzanie. Dla zwykłych użytkowników — nic. To rozwiązanie dla serwerów enterprise. Brak daty dostępności, brak nazwy produktu, brak próbek. Phison mówi, że wszystko jest wciąż w rozwoju.
| Parametr | Phison Computational-Storage SSD | Samsung SmartSSD (2. gen.) |
|---|---|---|
| Procesor | NPU + ARM Cortex (szacunkowo) | AMD Xilinx Versal FPGA |
| Pamięć | 64GB @ 130 GB/s (LPDDR5X?) | Brak danych |
| Obsługiwane frameworki | PyTorch, vLLM, OpenVINO, llama.cpp | Wymaga custom code |
| Zmniejszenie transferu danych | 10-100x (szacunkowo) | Brak danych |
| Status rynkowy | Prototyp (SC26) | Wycofany z rynku |
Najczęściej zadawane pytania (FAQ)
Co to jest computational storage i dlaczego Phison to robi?
Ile mocy obliczeniowej ma wbudowany NPU w dysku Phison?
Czy to rozwiązanie będzie dostępne dla zwykłych użytkowników?
Dlaczego poprzednie próby computational storage (Samsung SmartSSD) nie powiodły się?
💬 Gorąca dyskusja czytelników TechTendency
Pytanie od redakcji: Czy przesunięcie obliczeń AI bezpośrednio na dysk to przyszłość serwerów, czy zbyt skomplikowane rozwiązanie dla większości firm?
✍️ Przejdź do sekcji komentarzy