W skrócie (TL;DR)
- Nvidia RTX Spark N1X trafia do mini PC od Asus, Dell i MSI — pierwsze modele dostępne dzisiaj
- Specyfikacja: 6144-rdzeniowy GPU Blackwell, 20-rdzeniowy CPU Grace, do 128GB RAM
- Cena Asus ProArt GR1X: 4499 dolarów (~21 500 zł), czyli segment premium dla deweloperów
- Przeznaczenie: lokalne modele AI, narzędzia RTX-accelerated (Adobe, Blender), nie gry
Nvidia robi krok w kierunku demokratyzacji sprzętu dla deweloperów AI. Po laptopach RTX Spark, które pojawiły się wcześniej w tym roku, przyszła kolej na desktopy. Pierwsze mini PC z układem RTX Spark N1X są już dostępne od Asus, Dell i MSI, a Microsoft szykuje się do wysyłki Surface RTX Spark Dev Box. To nie jest kolejna fala gadżetów dla graczy — to sprzęt dla tych, którzy chcą uruchamiać duże modele językowe lokalnie, bez wysyłania danych do chmury.

Specyfikacja, która robi wrażenie (ale i robi dziurę w portfelu)
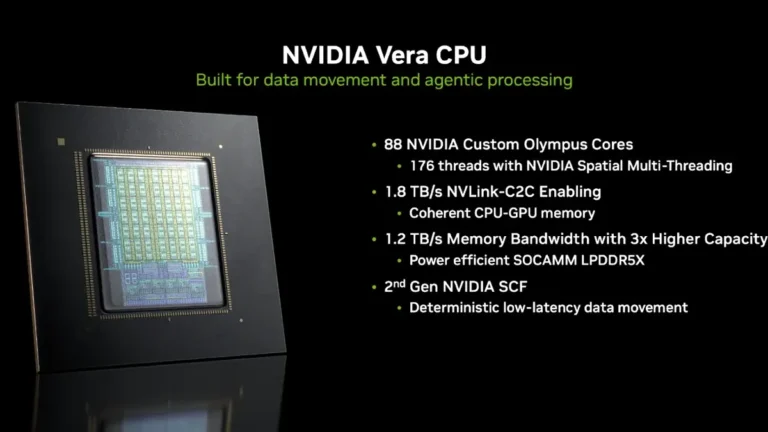
Zacznijmy od tego, co jest w środku. Układ RTX Spark N1X to połączenie 6144-rdzeniowego GPU Blackwell z 20-rdzeniowym CPU Grace. Do tego dochodzi do 128GB pamięci RAM — to jest konfiguracja, która pozwala na obsługę naprawdę dużych modeli AI bez kompromisów. Dla porównania: typowy laptop z RTX 4090 ma 24GB VRAM, a tutaj mamy dostęp do znacznie większej ilości pamięci współdzielonej między CPU a GPU.
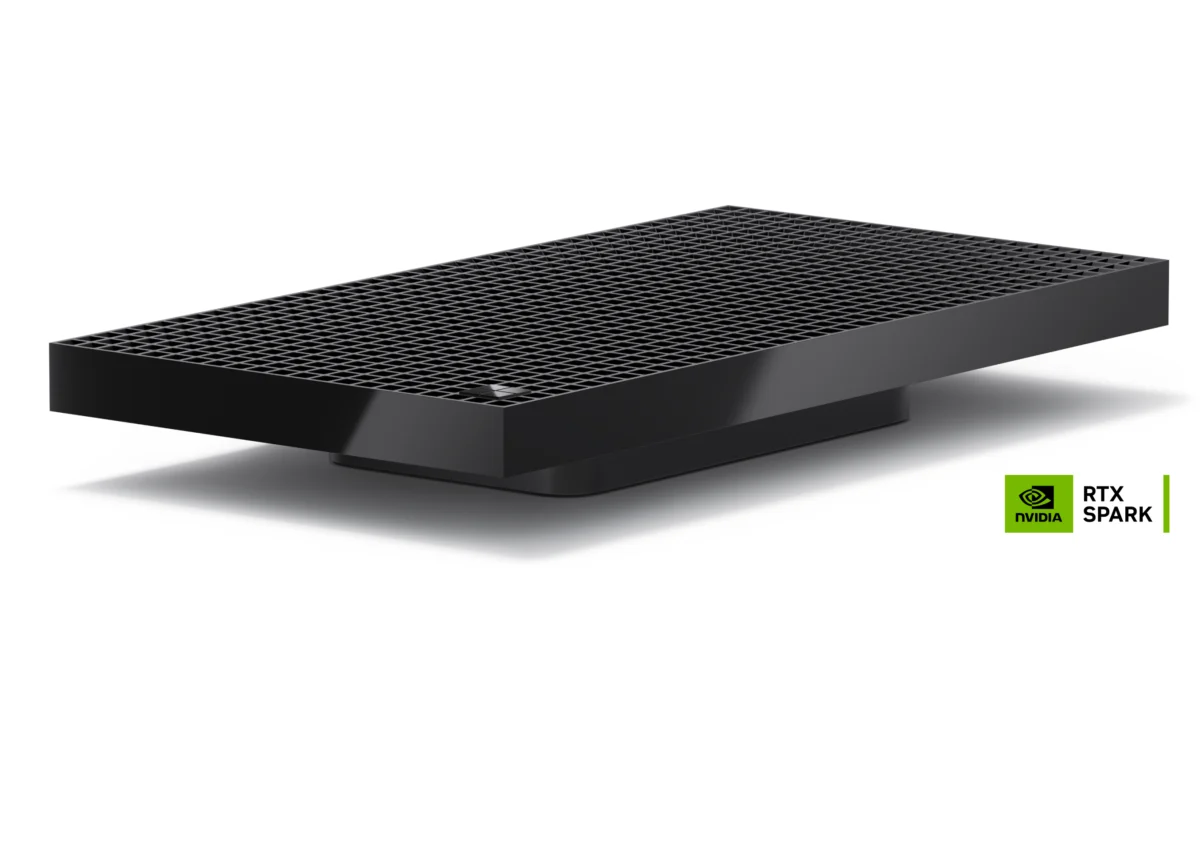
Asus ProArt GR1X, który jest jednym z pierwszych modeli dostępnych na rynku, startuje od 4499 dolarów w konfiguracji z 64GB RAM i 1TB dysku SSD. W Polsce, po przeliczeniu kursu i uwzględnieniu podatku VAT, należy spodziewać się ceny około 21 500–22 000 zł. To nie jest tanio, ale dla segmentu workstationów dedykowanych AI to cena rynkowa.
Nvidia obiecuje „do 1 petaflopa wydajności AI” — liczba, która brzmi imponująco, ale trzeba ją rozumieć w kontekście. Petaflop to bilion operacji zmiennoprzecinkowych na sekundę, ale rzeczywista wydajność zależy od typu modelu, precyzji obliczeń (FP32, FP16, INT8) i optymalizacji kodu. W praktyce oznacza to, że możesz uruchamiać modele takie jak Llama 2 70B czy większe wersje Claude lokalnie, bez opóźnień związanych z komunikacją sieciową.
Dla kogo to jest? Nie dla graczy, ale dla deweloperów
Tutaj trzeba być szczerym: jeśli myślisz o tym mini PC jako o maszynie do grania, to nie jest to dla ciebie. Nvidia sama przyznaje, że wsparcie dla gier na Windows on Arm wciąż się rozwija, a cena sprzętu jest zdecydowanie zbyt wysoka, aby uzasadniać zakup dla grania. To byłoby jak kupowanie Ferrari do jazdy po mieście — techniczny nonsens.
Docelowymi użytkownikami są deweloperzy pracujący z lokalnymi modelami AI, naukowcy, a także firmy, które chcą uruchamiać własne instancje LLM bez zależności od usług chmurowych takich jak OpenAI API czy Claude API. Dodatkowym atutem jest wsparcie dla narzędzi RTX-accelerated — Adobe Premiere Pro, Photoshop czy Blender 5.3 z nowym DLSS 4.5 Ray Reconstruction. To oznacza, że renderowanie i przetwarzanie wideo przyspieszą znacznie.
Mini PC ma też natywne wsparcie dla CUDA i dostęp do narzędzi Linux poprzez Windows Subsystem for Linux (WSL). Dla inżyniera pracującego z PyTorch, TensorFlow czy innymi frameworkami ML to oznacza, że może pracować w znanych mu środowiskach bez dodatkowych komplikacji.
Ekosystem rozszerza się — ale gdzie są alternatywy?
Nvidia nie jest sama w tym segmencie. Apple od lat oferuje MacBook Pro z chipami M-series, które również potrafią obsługiwać lokalne modele AI. Microsoft szykuje się do wysyłki Surface RTX Spark Dev Box. Acer, Gigabyte i HP zapowiedzieli swoje wersje mini PC, choć konkretne daty nie zostały ujawnione.
Problem w tym, że ekosystem RTX Spark jest wciąż młody. Podczas gdy Apple ma lata doświadczenia w optymalizacji ML na swoim krzemie, a Intel/AMD mają ogromny park instalacyjny, Nvidia buduje to od zera. To oznacza, że wsparcie dla oprogramowania, optymalizacja sterowników i dostępność narzędzi deweloperskich będą się rozwijać stopniowo.
Z perspektywy polskiego rynku sytuacja jest jeszcze bardziej skomplikowana. Cena 21–22 tys. zł to bariera dla małych startupów i zespołów. Dla porównania: komputer stacjonarny z RTX 4090 kosztuje około 12–15 tys. zł, a laptopy z RTX 4090 to 10–14 tys. zł. RTX Spark mini PC jest wyraźnie droższy, ale oferuje znacznie lepszą wydajność dla konkretnych zadań AI.
Praktyczne zastosowania i rzeczywisty wpływ
Gdzie to się sprawdzi? Przede wszystkim w firmach, które przetwarzają wrażliwe dane i nie mogą wysyłać ich do chmury. Agencje medyczne, firmy finansowe, kancelarie prawne — wszyscy oni mogą teraz uruchamiać modele AI lokalnie, zachowując pełną kontrolę nad danymi.
Drugi segment to naukowcy i inżynierowie pracujący nad własnymi modelami. Zamiast czekać na dostęp do GPU w chmurze (co kosztuje, a dostęp jest limitowany), mogą pracować lokalnie, eksperymentować i iterować szybciej.
Trzeci segment to content creators — osoby pracujące z Adobe Premiere Pro czy Blender, które mogą teraz liczyć na przyspieszenie renderowania i przetwarzania wideo dzięki RTX-acceleration.
Co to oznacza w praktyce?
Mini PC z RTX Spark to przesunięcie granicy tego, co możliwe lokalnie. Zamiast wysyłać dane do chmury, czekać na odpowiedź API i płacić za każde zapytanie, deweloper może teraz uruchamiać własne modele AI na własnym sprzęcie. To oznacza szybszą iterację, mniejsze koszty operacyjne i pełną kontrolę nad danymi. Jednak cena wejścia (21–22 tys. zł) pozostaje barierą dla małych zespołów.
| Parametr | Specyfikacja |
|---|---|
| GPU | Nvidia Blackwell RTX (6144 rdzeni) |
| CPU | Nvidia Grace (20 rdzeni) |
| Pamięć RAM | Do 128GB |
| Magazyn | Do 1TB SSD (konfiguracja bazowa) |
| Wydajność AI | Do 1 petaflopa |
| Wsparcie | CUDA, Linux (WSL), Adobe RTX, Blender DLSS 4.5 |
| Cena (Asus ProArt GR1X) | 4499 dolarów (~21 500 zł) |
Najczęściej zadawane pytania (FAQ)
Czy RTX Spark mini PC zastąpi laptopy dla deweloperów AI?
Czy mogę uruchamiać Llama 2 70B lokalnie na RTX Spark?
Jaka jest różnica między RTX Spark a MacBook Pro M4?
Czy warto czekać na wersje od Acer, Gigabyte i HP?
Czy to jest dobra inwestycja dla polskiego startupu AI?
💬 Gorąca dyskusja czytelników TechTendency
Pytanie od redakcji: Czy mini PC z AI acceleratorem za 4500 dolarów to przyszłość lokalnych modeli LLM, czy nadal zbyt drogo dla polskich deweloperów?
✍️ Przejdź do sekcji komentarzy