W skrócie (TL;DR)
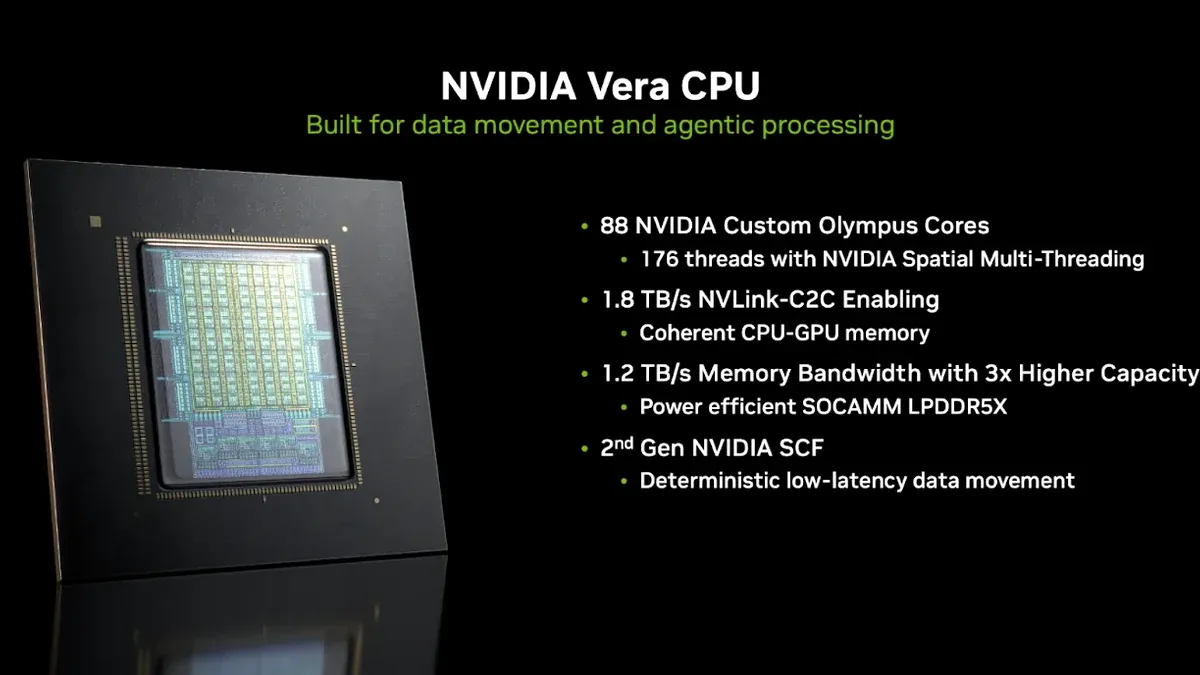
- Nvidia Vera z rdzeniami Olympus może osiągnąć 39% wzrost wydajności dzięki optymalizacjom kodu — ale bez nich działa tylko 20% szybciej od poprzednika Grace.
- Vera ma 88 rdzeni z 176 wątkami; Nvidia celowo wybrała mniej rdzeni, aby zmaksymalizować wydajność na rdzeń zamiast liczby.
- To nie jest CPU dla każdego — Nvidia jasno mówi, że Vera to narzędzie dla AI, przetwarzania danych i workloadów wymagających wysokiej przepustowości pamięci.
- Rdzenie Olympus mają sześć wektorowych jednostek SIMD (24 operacje FP64/cykl) zamiast czterech jak u Neoverse V2 (16 operacji FP64/cykl).
Na konferencji Supercomputing 2026 (SC26) Nvidia pokazała, co naprawdę potrafi jej nowy procesor Vera. Brzmi to jak zwykła marketingowa papka — 39% wzrostu wydajności — ale diabeł tkwi w szczegółach. Ten wzrost nie pojawia się magicznie. Trzeba przepisać kod, zmienić organizację danych w pamięci, przearanżować harmonogram instrukcji. To nie jest czar, to twarda inżynieria.

Architektura Olympus: sześć zamiast czterech
Zanim przejdę do liczb, muszę wyjaśnić, co Nvidia zmieniła. Poprzedni procesor Grace używał rdzeni Neoverse V2 — standardowego rozwiązania od Armu. Vera natomiast ma rdzenie Olympus, całkowicie własne opracowanie Nvidii. To nie jest kosmetyczna zmiana.
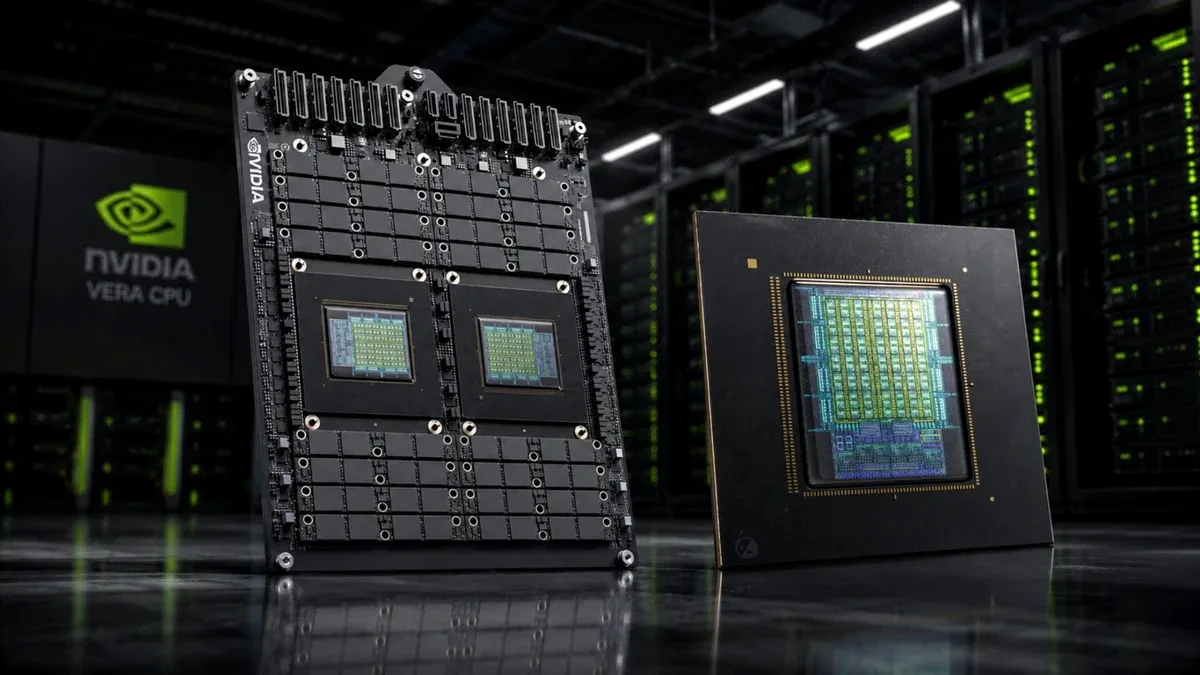
Rdzenie Olympus mają sześć wektorowych jednostek SIMD (Streaming SIMD Extensions), każda zdolna do wykonania czterech operacji zmiennoprzecinkowych na cykl zegara. To daje 24 operacje FP64 (zmiennoprzecinkowe podwójnej precyzji) na cykl. Neoverse V2 ma cztery takie jednostki, czyli 16 operacji na cykl. Różnica 50%. Ale to dopiero początek.
Olympus ma też 10-szeroki dekoder instrukcji, głęboką jednostkę out-of-order execution, cztery potoki ładowania i dwa potoki przechowywania danych, a wszystko to wsparte dużymi prywatnymi cache’ami i zaawansowanymi mechanizmami prefetch. Nvidia nie maksymalizowała liczby rdzeni na gniazdo — wybrała 88 rdzeni zamiast potencjalnie większej liczby. Dlaczego? Ponieważ każdy dodatkowy rdzeń zmniejsza miejsce na jednostki wykonawcze i cache. To gra w trade-offy.
Benchmark DGEMM: 20% bez optymalizacji, 39% z nimi
Nvidia użyła benchmarku miniKernelGEMM — mnożenia macierzy 128×128, które mieści się w L1 cache obu procesorów. To nie jest przypadkowa liczba. L1 cache to najszybsza pamięć, więc wynik pokazuje czystą wydajność rdzeni bez szumów opóźnień pamięci.
Kiedy badacze Nvidii uruchomili kod zoptymalizowany dla Neoverse V2 (czyli dla Grace), Vera osiągnęła 5,43 instrukcji na takt (IPC) i 15,69 operacji FP64 na cykl. Grace miał 4,51 IPC i 13,03 operacji FP64. To 20% wzrostu. Niezły wynik, ale nic spektakularnego.
Potem przyszła magia. Nvidia napisała kernel zoptymalizowany dla Olympus — zmienili organizację kafelków macierzy, alokację rejestrów i harmonogram instrukcji. Vera skoczyła do 7,53 IPC i 21,75 operacji FP64 na cykl. To 67% wzrostu wydajności na rdzeń na takt w stosunku do Grace. to nie jest całość. Vera osiągnęła 90,6% swojej teoretycznej przepustowości FP64, podczas gdy kod dla Neoverse V2 wykorzystywał tylko 66,5% możliwości Vera. To pokazuje, jak niedostatecznie były wykorzystywane nowe rdzenie.
Praktyka vs. teoria: kod musi się zmienić
Tutaj pojawia się kluczowa kwestia. Nvidia nie kryje się z tym, że istniejące oprogramowanie może działać na Vera bez żadnych zmian. Będzie szybsze niż na Grace, ale nie będzie wykorzystywać pełnego potencjału. To jak kupić samochód z silnikiem V12, ale jeździć nim po mieście na trzecim biegu.
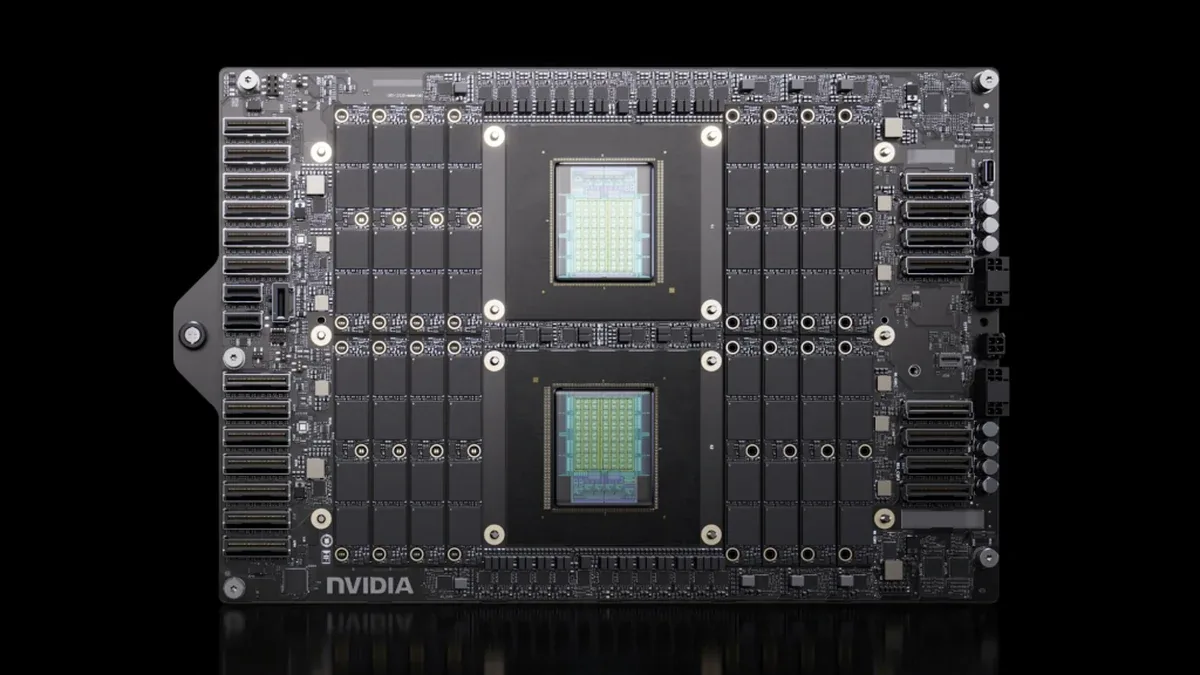
Hannah Coutand z zespołu marketingu Vera w Nvidii powiedziała to wprost: „Vera nie jest CPU ogólnego przeznaczenia. Jeśli chcesz serwer webowy dla swojego data center, są lepsze wybory. Vera jest dla workloadów, które wymagają wysokiej wydajności na rdzeń, wysokiej przepustowości pamięci i niskich opóźnień dostępu.”
To jest ważne. Vera to nie uniwersalny procesor. To narzędzie specjalistyczne. Deweloperzy, którzy chcą wycisnąć z niego 39% wzrostu wydajności, będą musieli przeanalizować swój kod, zrozumieć architekturę Olympus i przepisać krytyczne sekcje. To wymaga czasu, wiedzy i zasobów.
Dlaczego Nvidia wybrała mniej rdzeni?
Decyzja Nvidii, aby wybrać 88 rdzeni zamiast maksymalnej liczby, pokazuje filozofię projektowania. Każdy rdzeń zajmuje miejsce na chipie. Jeśli dodasz więcej rdzeni, musisz zmniejszyć jednostki wykonawcze, cache czy inne struktury wspierające. Nvidia wybrała mniej rdzeni, ale każdy z nich jest potężniejszy.
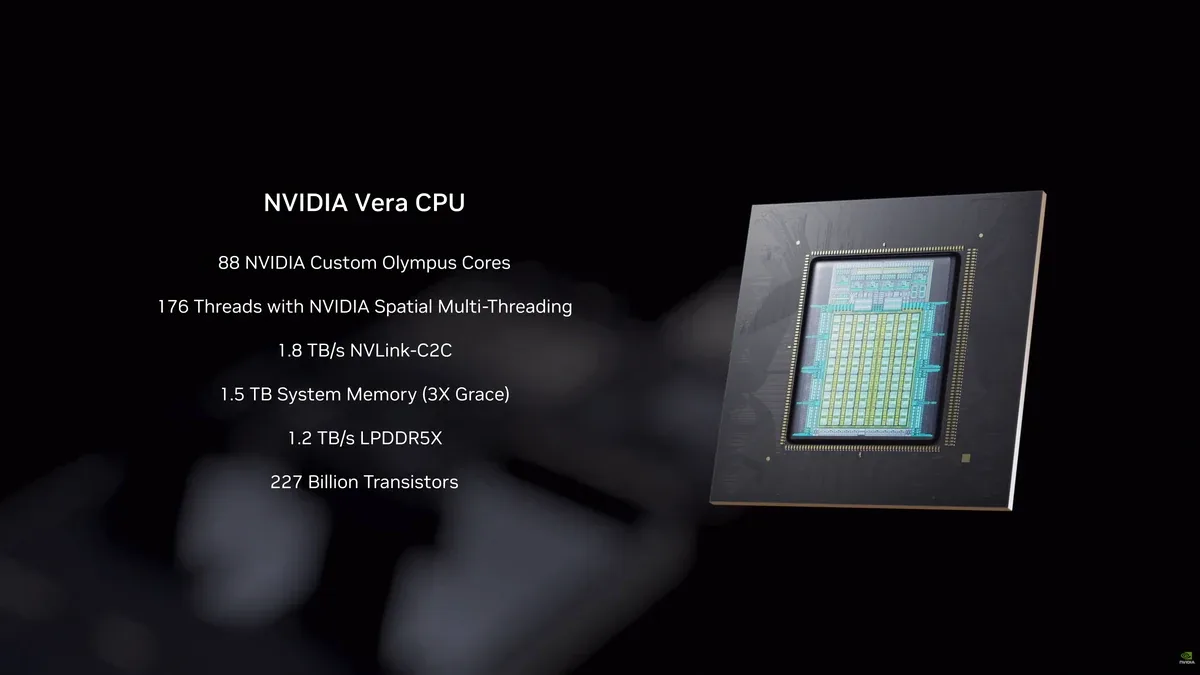
To podejście ma sens dla AI i przetwarzania danych. Te workloady nie zawsze potrzebują maksymalnej liczby rdzeni — potrzebują wysokiej wydajności na rdzeń i dużej przepustowości pamięci. Vera ma 176 wątków (88 rdzeni × 2 dzięki spatial multithreadingowi), co jest wystarczające dla większości scenariuszy.
Co to oznacza w praktyce?
Jeśli pracujesz nad modelami AI, przetwarzaniem dużych zbiorów danych lub aplikacjami wymagającymi wysokiej wydajności na rdzeń, Vera może być interesującą opcją. Ale musisz być gotów na optymalizację kodu. Bez niej zyskasz 20% wydajności. Z optymalizacjami możesz osiągnąć 39% wzrostu. To różnica między dobrym a świetnym wynikiem — ale wymaga pracy.
Ekosystem i przyszłość
Nvidia ma doświadczenie w budowaniu ekosystemów — CUDA to tego doskonały przykład. Gdy Vera będzie szerzej adoptowana, to doświadczenie może okazać się kluczowe. Producenci oprogramowania będą optymalizować swoje aplikacje dla Olympus, tak jak robią to dla CUDA.
Ale to zajmie czas. Intel i AMD przez dziesięciolecia budowały ekosystemy wokół swoich procesorów. Nvidia zaczyna od zera w segmencie CPU. To nie jest niemożliwe — ale wymaga konsekwencji i wsparcia dla partnerów.
Najczęściej zadawane pytania (FAQ)
O ile procent szybszy jest Vera od Grace w praktyce?
W testach DGEMM (mnożenie macierzy) Vera osiąga 67% wyższą wydajność na rdzeń na takt w stosunku do Grace, ale to przy kodzie zoptymalizowanym dla rdzeni Olympus. Bez optymalizacji różnica wynosi około 20%. W praktyce rzeczywisty wzrost wydajności będzie zależeć od tego, czy oprogramowanie zostało zoptymalizowane dla Olympus.
Ile rdzeni ma procesor Vera?
Vera ma 88 rdzeni ogólnego przeznaczenia z obsługą technologii spatial multithreading, co daje łącznie 176 wątków. Nvidia celowo wybrała mniej rdzeni niż teoretycznie możliwe, aby zmaksymalizować wydajność na rdzeń zamiast liczby.
Do czego Nvidia przeznacza Vera?
Vera jest pozycjonowana jako CPU dla workloadów AI (agentyczne AI) oraz aplikacji wymagających wysokiej wydajności na rdzeń, dużej przepustowości pamięci i niskich opóźnień dostępu. Nie jest to procesor dla serwerów webowych ani ogólnego przeznaczenia.
Jakie są różnice między rdzeniami Olympus a Neoverse V2?
Rdzenie Olympus (w Vera) mają sześć wektorowych jednostek SIMD (mogą wykonać 24 operacje FP64 na cykl), podczas gdy Neoverse V2 (w Grace) ma cztery takie jednostki (16 operacji FP64 na cykl). Olympus ma też 10-szeroki dekoder instrukcji, głęboką jednostkę out-of-order execution, cztery potoki ładowania i dwa potoki przechowywania, wsparte dużymi prywatnymi cache’ami i zaawansowanymi mechanizmami prefetch.
Czy istniejące oprogramowanie będzie działać na Vera bez zmian?
Tak, istniejące oprogramowanie będzie działać na Vera bez żadnych zmian. Będzie szybsze niż na Grace (około 20% wzrostu wydajności), ale nie będzie wykorzystywać pełnego potencjału rdzeni Olympus. Aby osiągnąć 39% wzrost wydajności, kod musi być zoptymalizowany dla nowej architektury.
💬 Gorąca dyskusja czytelników TechTendency
Pytanie od redakcji: Czy uważasz, że 39% wzrost wydajności dzięki optymalizacjom to wystarczająca motywacja dla deweloperów, aby przepisywać kod dla nowych architektur procesorów?
✍️ Przejdź do sekcji komentarzy