W skrócie (TL;DR)
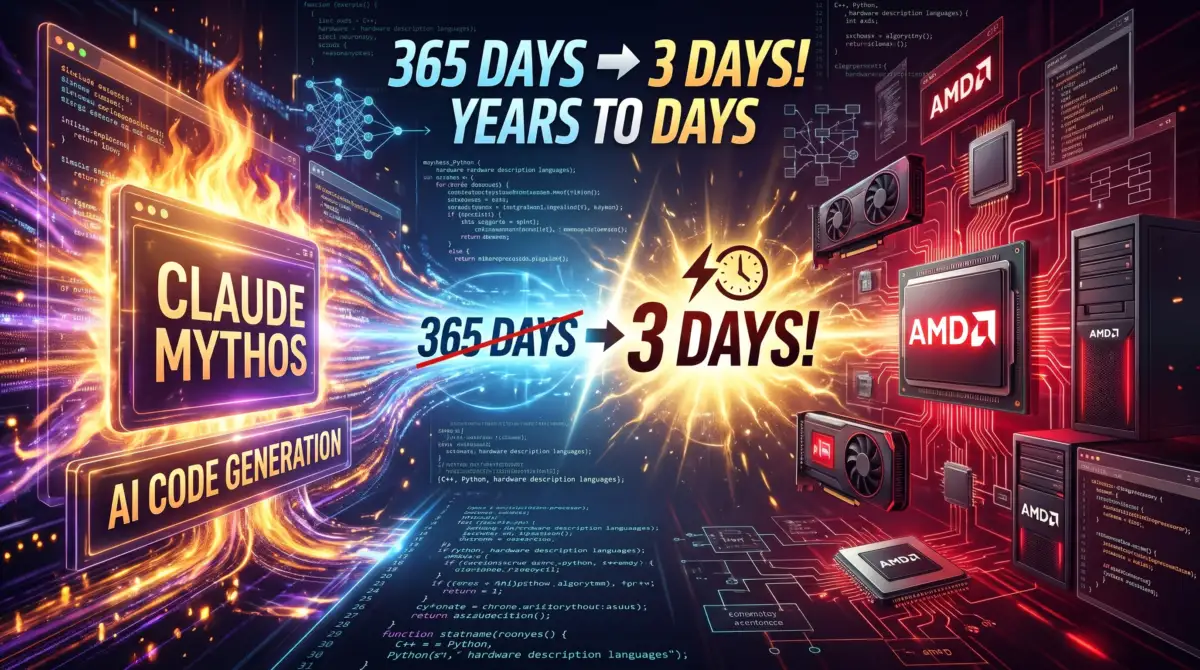
- Claude Mythos napisał kod kerneli GPU dla AMD MI355X w 3 dni zamiast tradycyjnych 6–12 miesięcy
- AI generowała prawie 100% kerneli autonomicznie, bez udziału zespołu inżynierów
- To podważa monopol CUDA Nvidii — bariera wejścia dla konkurencyjnych chipów drastycznie spada
- Anthropic zarządza infrastrukturą jako multi-chip pool (Nvidia, AMD, Google TPU, AWS Trainium)
Kiedy czytam o tym, co Anthropic właśnie pokazał inwestorom, widzę moment zwrotny dla całej branży chipów. Claude Mythos — najnowszy model AI Anthropic — napisał niskopoziomowy kod (kernele GPU) dla procesorów AMD Instinct MI355X w około trzy dni. Praktycznie bez pomocy człowieka. To zajmowało tradycyjnie od sześciu do dwunastu miesięcy.
Tom Brown, współzałożyciel i chief compute officer Anthropic, powiedział inwestorom, że oryginalny proces wymagał zespołu „dziesiątek inżynierów”. Teraz? Jeden inżynier poprosił Claude’a, aby uruchomił model na MI355X, a następnie… zostawił to działać przez weekend.
To nie jest zwykłe przyspieszenie. To atak na fundamenty monopolu, który Nvidia budowała przez prawie dwie dekady.

CUDA: Forteca, która zaczyna się sypać
CUDA to platforma programistyczna Nvidii. Przez dwadzieścia lat była praktycznie bezkonkurencyjna — każdy, kto chciał uruchomić model AI na GPU, musiał pisać kod dla CUDA. To tworzyło wąskie gardło. Nowe procesory (AMD, Google TPU, AWS Trainium) musiały czekać miesiące, aż inżynierowie ręcznie przepisywali kod z CUDA na ich natywne API.
AMD ma ROCm — równoważną platformę. Ale konwersja kodu z CUDA na ROCm zawsze była bólem głowy. AMD nawet zbudowało narzędzie HIPify, aby automatyzować ten proces. Jednak — jak powiedział Anush Elangovan, wiceprezydent AMD ds. oprogramowania AI — „Claude jest lepszy niż HIPify, bo ma wbudowaną wyszukiwarkę internetową”.
Teraz Claude Mythos robi coś radykalnie innego: pisze kernele od zera, autonomicznie, bez konwersji. To zmienia całą grę.
Architektura multi-chip: Niekonwencjonalne zagranie, które się opłaciło
Anthropic od początku podjęło niekonwencjonalną decyzję: nie uzależniać się od jednego producenta chipów. Zamiast tego, firma zarządza swoją infrastrukturą obliczeniową jako „jeden fungibilny pool” obejmujący GPU Nvidii, AMD, Google TPU i AWS Trainium. To oznacza, że mogą szybko przesuwać obciążenia między platformami bez blokady technologicznej.
Ta strategia — którą Tom Brown nazwał „niekonwencjonalnym zagraniem” — okazała się mądra. Gdy Google pokazało, że TPU mogą natywnie uruchamiać modele PyTorch, a Meta zaczęła je używać w produkcji, Anthropic już miało infrastrukturę do tego przygotowaną. Teraz, gdy Claude Mythos przyspieszył integrację AMD, mogą skalować bez czekania na tradycyjne procesy inżynierskie.
Jak AI pisze kernele lepiej niż inżynierowie?
Tutaj robi się ciekawie. Kernele GPU to niskopoziomowy kod, który musi być precyzyjnie dostrojony do konkretnej architektury sprzętu. Tradycyjnie wymagało to głębokie zrozumienia zarówno algorytmu, jak i specyfiki chipów.
Claude Mythos ma dostęp do dokumentacji AMD, przykładów kodu, benchmarków i — co ważne — może iterować szybko. Jeśli kernel nie działa optymalnie, model może go natychmiast poprawić. Vamsi Boppana, senior vice president AMD ds. AI, powiedział, że w niektórych przypadkach kernele generowane przez AI były nawet „lepsze niż ręcznie dostrojone wersje”.
To nie jest przypadek. AI może eksplorować przestrzeń optymalizacji szybciej niż człowiek. Może testować tysiące wariantów kodu w ułamku czasu, który zajęłby inżynierowi.
Co to oznacza dla Nvidii?
Jensen Huang, CEO Nvidii, powiedział niedawno: „Używamy ogromnej ilości AI do tworzenia kerneli, które mamy; nikt nie zna naszej architektury lepiej niż my”. To jest obronna pozycja. Nvidia ma przewagę: głębokie zrozumienie własnego sprzętu, dwie dekady optymalizacji, ekosystem narzędzi.
Ale jeśli AI potrafi autonomicznie generować kernele dla konkurencyjnych chipów, ta przewaga topnieje. Andrew Dieckman, corporate vice president AMD ds. biznesu GPU w data center, powiedział coś znaczącego: „Mam praktycznie zero rozmów z naszymi klientami o CUDA w tym momencie”.
To mówi wszystko. Klienci przestają pytać o CUDA, bo mogą teraz szybko przechodzić między platformami.
Praktyczne konsekwencje dla branży
Dla organizacji, które budują infrastrukturę AI, to oznacza drastycznie zmniejszoną blokadę technologiczną. Zamiast czekać miesiące na integrację nowego chipów, mogą to zrobić w dni. To otwiera drzwi dla rzeczywistej konkurencji między producentami chipów — nie na poziomie architektury, ale na poziomie ceny, wydajności i dostępności.
AMD już ma umowę z Anthropic na dostarczenie do 2 gigawatów mocy obliczeniowej. To nie jest mała liczba. To oznacza, że AMD może teraz realnie konkurować z Nvidią w segmencie AI, bez czekania na tradycyjne procesy integracyjne.
Dla mniejszych graczy — startupów, badaczy — to oznacza więcej opcji. Nie muszą być uzależnieni od ekosystemu Nvidii. Mogą wybrać chipsy na podstawie ceny i wydajności, a nie na podstawie tego, czy istnieje już kod dla CUDA.
Co to oznacza w praktyce?
Jeśli jesteś inżynierem budującym infrastrukturę AI: możesz teraz realnie rozważać AMD MI355X bez obawy, że integracja zajmie rok. Jeśli jesteś decydentem w dużej organizacji: masz więcej opcji do negocjowania cen z producentami chipów. Jeśli jesteś badaczem: możesz eksperymentować z różnymi platformami bez blokady technologicznej.
Najczęściej zadawane pytania (FAQ)
Ile czasu tradycyjnie zajmowało napisanie kerneli GPU dla nowych procesorów?
Co dokładnie zrobił Claude Mythos w trzy dni?
Czy to oznacza koniec monopolu CUDA?
Jakie są różnice między CUDA a AMD ROCm?
Czy Anthropic już uruchamia modele na AMD MI355X w produkcji?
💬 Gorąca dyskusja czytelników TechTendency
Pytanie od redakcji: Czy to koniec ery CUDA? Jak szybko AMD może przejąć rynek, jeśli AI będzie pisać kernele szybciej niż inżynierowie?
✍️ Przejdź do sekcji komentarzy